Jak připojit AI agenta na Ads API, aniž by token skončil v chatu
Praktický postup od oficiální dokumentace přes skill a evaly až po 1Password a connection profile. Agent se dostane k Ads API, ale token nikdy nedostane do promptu.
Začalo to větou, kterou jsem viděl už mockrát:
„Tady máš token, napoj se na účet a udělej mi report.“
Technicky to funguje. Za chvíli máš v chatu čísla z Meta Ads.
Jenže tím tokenem se staly dvě věci. Dal jsi AI agentovi klíč od reklamního účtu. A zároveň ten klíč odešel z tvého počítače — spolu s promptem, do historie konverzace, do logů a dost možná i do souborů projektu.
Token není další kus kontextu k zadání. Je to přístupový údaj.
Neříkám, že AI nemá na reklamní účty vůbec sahat. Naopak. Ranní kontrola spendu, pravidelný report, kontrola kampaní, příprava draftu nebo hromadné nahrání kreativ jsou přes API přesně ty věci, kde agent dává smysl.
Jen jsem chtěl, aby platily tři jednoduché věci:
- agent rozumí konkrétní platformě a ví, kdy má radši přestat než hádat,
- credential zůstává mimo chat, repozitář i příkazovou řádku,
- stejné řešení jde rozumně zopakovat pro dalšího klienta a další platformu.
Takhle dnes stavím přístup k Meta Ads, Google Ads a dalším reklamním API.
Pracovní checklist se všemi kroky, kontrolami a vzorovým connection profilem.
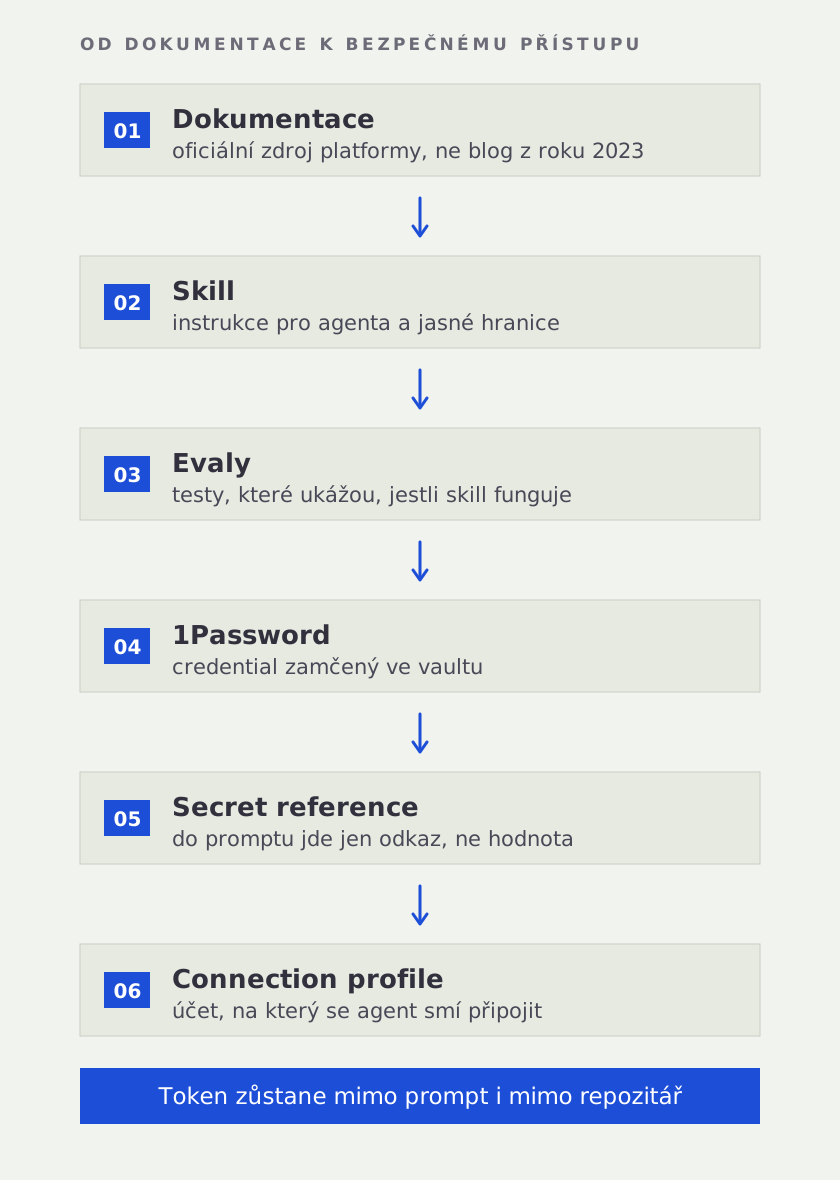
Řekni AI, ať vychází z API dokumentace. Ne z fór.
První krok není „napiš mi skill pro Meta Ads“.
První krok je říct agentovi, kde má čerpat. Tohle je věc, kterou lidi často vynechají a pak se diví výsledku. Když agentovi nedáš zdroj, sáhne po tom, co má v sobě — po tréninkových datech, po starých odpovědích, po čemkoliv, co vypadá podobně. A to je přesně ten problém.
U Ads API se mění verze, oprávnění, limity i způsob přihlášení. Návod z Redditu nebo odpověď z roku 2024 můžou vypadat sebevědomě a být špatně. A protože jde o request, který se dotýká klientského účtu, špatná odpověď není jen nepříjemná — může poslat data na špatný účet nebo zneplatnit token.
Takže agentovi řekni dvě věci:
- Odkud má čerpat. Přímý odkaz na oficiální dokumentaci konkrétní platformy.
- Že má dokumentaci vždycky dohledat, ne si ji pamatovat. Když si není jistý endpointem, polem nebo verzí, otevře dokumentaci. Když ji nemá, zastaví se a řekne to.
Ukážu to na Metě, protože je to asi nejčastější případ.
Když si otevřeš Marketing API, najdeš tam všechno, co potřebuješ vědět, než pošleš první request. Pro začátek se vyplatí projít hlavně Get Started průvodce, kde je popsané, jak funguje účet, appka, system user a oprávnění.
Tři věci, které si z dokumentace odneseš a které se pak přímo propíšou do skillu:
- Verze API. Meta pravidelně vydává nové verze Graph API. Agent musí používat konkrétní, explicitně zvolenou verzi. Ne „tu poslední, co si někde našel“.
- Oprávnění.
ads_readstačí na reporting.ads_managementpotřebuješ až ve chvíli, kdy chceš něco měnit. Pro běžný přehled spendu je tedy zbytečné dávat agentovi právo zapisovat. - Přístup k účtu. Appka musí být nainstalovaná na správném system userovi a ten musí mít na konkrétním ad accountu odpovídající roli (
ANALYZE,ADVERTISEneboMANAGE).
A pak je tady ještě čtvrtá věc, která se z dokumentace nepozná: jak ověřit, že opravdu míříš na správný účet.
Nezačínej vytvořením kampaně. Začni tím, že si necháš vrátit název účtu, měnu, časové pásmo a stav účtu. Je to nejnudnější možný request a zároveň nejlepší test. Když sedí tohle, sedí i token, oprávnění a scope.
Nech AI vytvořit skill, ne jednorázový prompt
Jednorázový prompt je fajn, když chceš jednou stáhnout čísla. Skill je lepší, když chceš, aby agent stejnou práci dělal za týden, za měsíc a pro jiný účet bez toho, aby pokaždé znovu vymýšlel základní postup.
Skill je v zásadě složka s instrukcemi. Agent z ní načte jen to, co potřebuje, a to až ve chvíli, kdy se to hodí k zadání. Kam ji uložit se liší podle nástroje:
| Nástroj | Globálně | V projektu |
|---|---|---|
| OpenCode | ~/.config/opencode/skills/ | .opencode/skills/ |
| Claude Code | ~/.claude/skills/ | .claude/skills/ |
| Codex | ~/.agents/skills/ | .agents/skills/ |
Struktura je všude stejná: složka s názvem skillu a v ní SKILL.md. Vedle můžou být reference, které si agent načte, až když je potřebuje.
Do dobrého Ads skillu nedávám jen seznam endpointů. Dávám mu hlavně hranice rozhodování:
---
name: meta-marketing-api
description: Reportuje a spravuje Meta Ads přes oficiální Marketing API.
Použij při dotazech na Meta Ads, kampaně, Insights nebo kreativy.
Před odpovědí si vždy ověř endpoint a verzi v oficiální dokumentaci.
Reporting prováděj read-only; změnu účtu proveď jen při explicitním zadání.
---

## Connection a scope

- Používej jen oficiální, verzované Graph API.
- Před první prací ověř účet read-only requestem.
- Pokud není account scope jednoznačný, zastav a zeptej se.
- Když v dokumentaci nenajdeš endpoint nebo pole, zavolej to. Nevymýšlej ho.

## Režimy

- `report`: pouze GET requesty a Insights
- `draft`: připrav payload bez zápisu
- `execute`: až po explicitním zadání, validaci a read-backu
Tenhle kus je schválně nudný. A to je dobře.
Agent tím dostane odpověď na otázky, které by jinak rozhodoval nahodile: Jak pozná klienta? Kam API request vůbec smí poslat? Co musí zkontrolovat před zápisem? Kde si má ověřit endpoint? Co udělá, když něco nesedí?
Do skillu bych rozdělil minimálně tyto části:
- Popis a trigger — kdy se má skill načíst.
- Connection a scope — odkud se vezme účet a jak se ověří.
- Režimy práce — reporting, draft, execute.
- Guardrails — co vyžaduje explicitní potvrzení, co se nesmí dělat vůbec.
- Reference — konkrétní endpointy, payloady a odkazy na oficiální dokumentaci.
- Výstup — jak má agent vrátit výsledek, zdroj dat a další krok.
Do obecného skillu naopak nepatří client ID, název vaultu, výkon kampaně, token ani jakákoliv jiná věc, která dává smysl jen pro jednoho klienta.
Skill nenech jen ležet. Dej mu možnost se zlepšovat.
Nejzajímavější věc na skillu není to, co v něm je napsané na začátku. Je to to, co se do něj dopíše po pár reálných použitích.
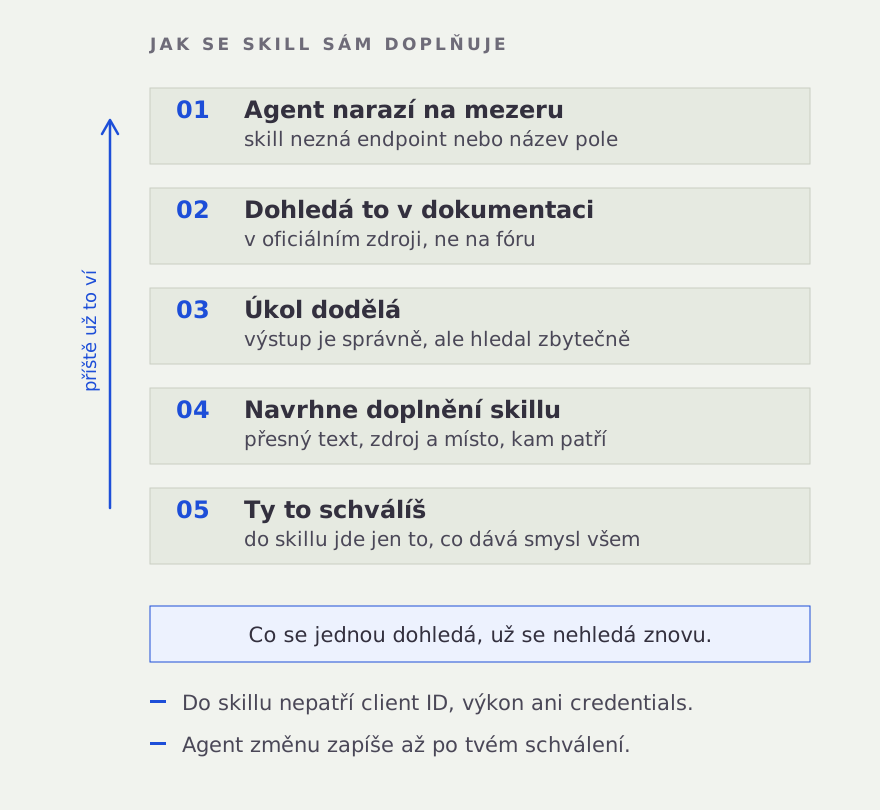
Představ si běžnou situaci. Pošleš agentovi zadání, on sáhne po skillu a v půlce narazí. Chybí mu konkrétní endpoint, nezná správný název pole nebo si není jistý formátem odpovědi. Takže jde na web, dohledá to v API dokumentaci a úkol dodělá.
A teď to důležité: když už tu informaci jednou hledal, neměl by ji příště hledat znovu.
Většina lidí tuhle situaci nechá být. Agent si poradil, úkol je hotový, jde se dál. Jenže tím se zahodila jediná cenná věc z celého běhu — zjištění, co ve skillu chybělo. Příští týden to bude hledat znovu. A za měsíc taky.
Místo toho chci, aby se to zapsalo do skillu:
- Agent během runu zjistí, že musí něco dohledat, protože to skill neobsahuje.
- Po dokončení úkolu navrhne konkrétní doplnění — co našel a kam to patří.
- Ty to zkontroluješ, protože návrh může být špatně nebo se týkat jen jednoho klienta.
- Po schválení se informace zapíše do skillu a příště je k dispozici.
V praxi to znamená dvě věci.
Za prvé, skill musí mít místo, kam se to zapisuje. Když je celý v jednom SKILL.md, začne po pár měsících bobtnat. Proto základní instrukce držím krátké a konkrétní věci posílám do referencí:
meta-marketing-api/
├── SKILL.md                    # pravidla, režimy, hranice
└── references/
    ├── core-operations.md      # endpointy a payloady
    └── troubleshooting.md      # co dělat, když...
Za druhé, agent musí vědět, že to má dělat. Do skillu proto patří instrukce typu:
## Po dokončení úkolu

Když jsi musel dohledávat informaci, kterou skill neobsahoval,
navrhni konkrétní doplnění.

Uveď:
- co ti chybělo a při jakém zadání,
- přesný text, který se má doplnit,
- zdroj v oficiální dokumentaci.

Nezapisuj změnu sám. Nech ji ke schválení.
Do skillu nikdy nedávej client ID, výkon ani credentials.
Pak je tady ještě druhá rovina: ověřit, že skill funguje dobře i v situacích, které jsi sám nevymyslel. K tomu se hodí pár testovacích zadání a binární kontroly.
Pro Meta reporting by zadání mohla vypadat třeba takto:
- „Udělej přehled spendu, konverzí a CPA za posledních 7 dní.“
- „Najdi kampaně, které za poslední tři dny utratily víc než 5 000 Kč a nemají nákup.“
- „Připrav návrh, jak pozastavit tři konkrétní ad sety. Nic neměň.“
A kontroly nejsou „zní to dobře“. Jsou to otázky, na které jde odpovědět ano/ne:
- Použil výstup jen data ze správně vybraného účtu?
- Zůstal v režimu
report, když zadání nepožadovalo změnu? - Uvedl období, zdroj dat a metodu měření?
- Neobsahuje výstup token, secret reference ani raw API odpověď?
- Zastavil se u nejednoznačného scope místo hádání?
Pro tuhle práci existují i skilly typu skill-creator a autoresearch. Pomůžou připravit testy, baseline, výsledky i changelog jednotlivých úprav. Důležitější než konkrétní nástroj je ale disciplína: originál skillu nech být, klientská data do něj nedávej a každou změnu si nejdřív projdi.
Token patří do 1Passwordu. Ne do chatu a ideálně ani do .env souboru.
.env je proti vložení tokenu do promptu krok správným směrem. Pořád je to ale soubor, který může někdo omylem nahrát, zkopírovat, přidat do zálohy nebo přehlédnout při sdílení projektu.
Pro credentialy k reklamním účtům používám 1Password. Pro každého klienta jeden vault a v něm samostatnou položku pro každou platformu. Hodnota patří do concealed fieldu, ne do poznámky.
| 1Password položka | Concealed field | Co v něm je |
|---|---|---|
Meta Ads API | META_ACCESS_TOKEN | Meta system-user access token |
Google Ads API | GOOGLE_SERVICE_ACCOUNT_JSON | service-account JSON |
ChatGPT Ads API | OPENAI_ADS_API_KEY | API key k Ads účtu |
Pinterest Ads API | PINTEREST_ACCESS_TOKEN | OAuth access token |
TikTok Ads API | TIKTOK_ACCESS_TOKEN | Business API access token |
Prakticky to znamená, že agent nikdy nedostane instrukci „tady je token“. Dostane maximálně informaci, že daná platforma má credential v konkrétní položce 1Passwordu a že jej má při requestu načíst bezpečnou cestou.
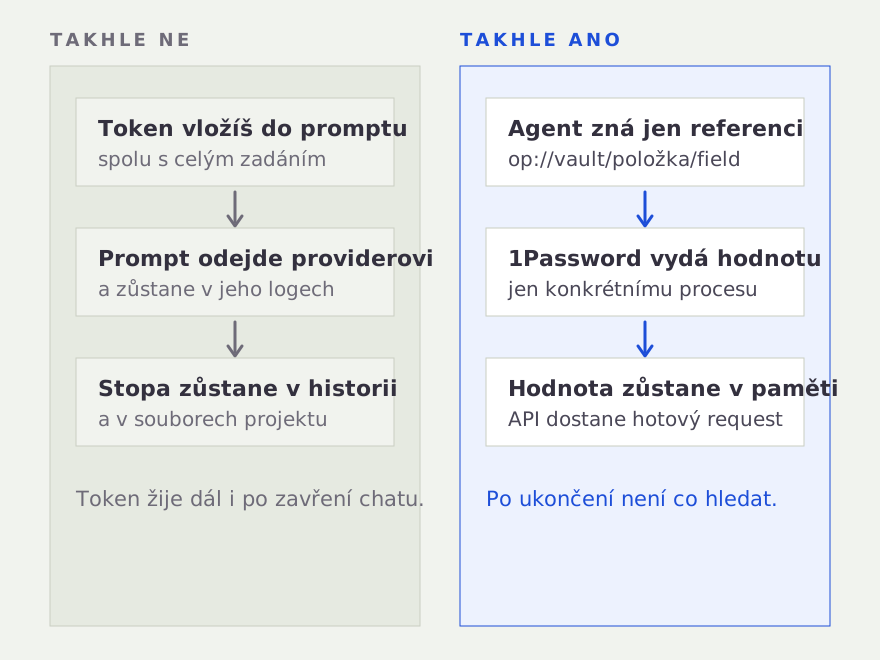
Napoj skill na 1Password CLI. Nebo ještě lépe na lokální runtime.
1Password má CLI op, které umí pracovat se secret references. V základním scénáři můžeš přes op run dodat secrety jako environment variables jen konkrétnímu procesu. Existuje také op read a op inject.
To je dobrý start. Ale u Ads API jsem nechtěl, aby se token dostal ani do proměnné prostředí širšího shell procesu, do URL nebo do hlavičky, kterou člověk vidí v historii příkazů.
Proto jsem si nad tím postavil malý lokální runtime s 1Password Desktop SDK:
- agent pošle strukturovaný request lokálnímu daemon clientu,
- daemon si podle connection profilu sestaví interní secret reference,
- 1Password může vyžádat biometrické potvrzení,
- token se načte až v paměti daemonu,
- daemon pošle request na oficiální API,
- agent dostane zpět jen redigovanou odpověď.
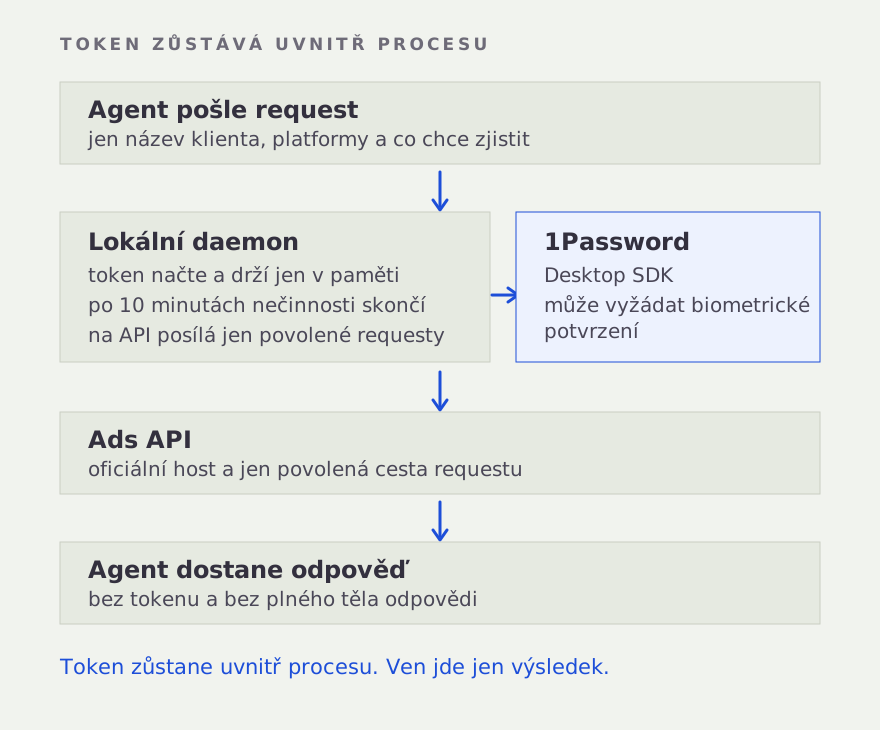
V mém runtime se daemon po 10 minutách nečinnosti ukončí a nejpozději po 30 minutách přejde do ukončovacího režimu. Každý profil má vlastní lokální socket s právy 600. API hosty a cesty jsou allowlistované, takže request nejde přesměrovat na libovolnou URL. A pokud upstream vrátí chybu, agent dostane krátkou sanitizovanou diagnostiku — ne celé tělo odpovědi, které by mohlo obsahovat něco citlivého.
Není nutné stavět hned stejný runtime. Základní princip ale drží i s CLI: secret reference není secret a hodnotu načítej až při spuštění konkrétního procesu.
Přidej connection profile, aby agent nehledal účty naslepo
Token sice nepatří do souboru, ale agent pořád potřebuje vědět, na jaký účet má mířit. Tady přichází na řadu connection profile.
Je to obyčejný JSON s netajnými provozními metadaty: název klienta, 1Password account a vault, ad account ID, manager ID, API verze nebo typ Google Ads účtu.
{
  "version": 2,
  "name": "example-client",
  "onepassword_account": "my-1password-account",
  "onepassword_vault": "Example Client API",
  "platforms": {
    "google_ads": {
      "auth_type": "service_account_json",
      "account_type": "client",
      "customer_id": "1234567890",
      "api_version": "v25"
    },
    "meta": {
      "ad_account_id": "act_1234567890",
      "api_version": "v25.0"
    }
  }
}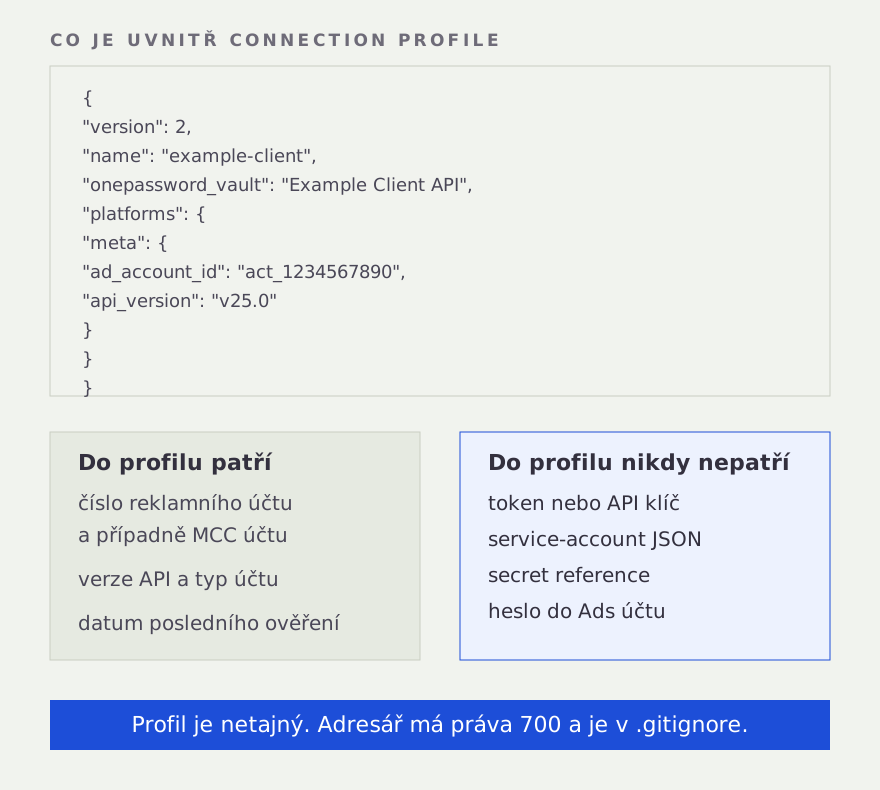
Do profilu patří:
- ověřené account ID a případně manager/MCC ID,
- aktuální API verze,
- informace, zda jde o client nebo manager účet,
- název 1Password vaultu a accountu,
- datum ověření připojení.
Do profilu nepatří token, API key, service-account JSON, heslo ani 1Password secret reference.
Profily dávám mimo skill a mimo sdílený repozitář, například do .opencode/ads-api-connections/. Celá složka má práva 700 a je v .gitignore. Resolver ji pak najde sám podle otevřeného projektu. Když existuje právě jeden ověřený profil pro Meta, agent nemusí nic hledat. Když jsou dva, musí se zeptat, pro kterého klienta pracuje.
To zní jako drobnost, ale právě ona brání větě: „Vzal jsem první účet, který jsem našel.“
První request je probe. Ne live změna.
Po nastavení profilu chci nejdřív read-back. U Mety typicky načtu název účtu, account_id, měnu, časové pásmo a account_status. Teprve když to sedí, označím platformu v profilu jako ověřenou.
Teprve pak přichází běžná práce:
- report — jen čtení dat,
- draft — přesný návrh payloadu, ale bez zápisu,
- execute — explicitně zadaná změna s validací a následnou kontrolou výsledku.
U create operací je rozumný default PAUSED. Kampaň, ad set ani reklama by se neměly samy aktivovat jen proto, že agent správně složil payload. U platformy, která podporuje validate_only, ji používám před každým zápisem. Po zápisu následuje read-back: načti změněný objekt a ověř, že má správný status i hodnoty.
Mazání je samostatná disciplína. V mém setupu vyžaduje explicitní „ano, znič to“. Ne proto, že by agent neuměl poslat DELETE, ale protože marketingové rozhraní není sandbox a špatně zvolený účet není teoretický problém.
Co bych dnes už nedělal
- Nevkládal bych token do promptu, ani „jen na chvíli“.
- Nedával bych do obecného skillu cokoli klientsky specifického.
- Nenechal bych agenta vybrat účet podle názvu odhadem.
- Nezačínal bych prvním requestem, který něco vytváří nebo aktivuje.
- Nenechal bych self-improvement smyčku sahat na živá data bez izolovaných testů a jasných evalů.
- Nevěřil bych automaticky starému kódu nebo staré dokumentaci jen proto, že minule fungovaly.
Není to o tom pustit AI na reklamu bez dozoru
Největší přínos pro mě není v tom, že teď může agent bez omezení „spravovat Meta Ads“.
Je v tom, že můžu bezpečně delegovat konkrétní kusy práce: vytáhnout report, připravit draft, zkontrolovat rozjetý spend nebo projít strukturu kampaní. A když dojde na změnu, systém má několik míst, kde se musí zastavit a kde pořád rozhoduju já.
To je podle mě rozumnější představa AI v marketingu. Ne další člověk s admin přístupem. Spíš rychlý kolega, který zná pravidla, pracuje v jasném scope a nikdy nemusí vidět klíče od účtu.
V checklistu je celý postup připravený jako pracovní materiál: dokumentace, skill, evaly, 1Password, connection profile i první bezpečný probe.